Le parsing de CV extrait et organise des informations comme les expériences, la formation, les compétences et les langues. Il aide à repérer les champs à vérifier, mais l’extraction peut manquer un élément ou mal interpréter une mise en page : comparez les données au document source avant de les utiliser pour orienter une décision.
Que fait un parser de CV ?
Un parser convertit le contenu d’un CV en champs structurés, par exemple les expériences professionnelles, la formation, les compétences ou les langues. L’équipe peut ensuite retrouver ces informations dans un processus de recrutement plutôt que de relire chaque document sans repère. L’extraction prépare le travail; elle ne confirme pas à elle seule qu’une expérience correspond aux critères du poste.
Le résultat dépend du document et des champs reconnus. Une mise en page à plusieurs colonnes, un PDF numérisé, des dates ambiguës ou des intitulés très spécialisés peuvent produire des champs incomplets ou mal associés. Un CV lisible par un humain ne garantit pas que chaque élément sera extrait comme prévu.
Définir les champs qui comptent pour le poste
Avant de comparer des outils, choisissez les informations nécessaires à votre workflow. Pour une recherche de technicien de maintenance, l’équipe peut vouloir retrouver les expériences, la formation, les compétences et les langues, puis vérifier si les postes mentionnent une intervention sur site. Le titre du poste ou une compétence isolée ne prouve pas l’étendue des responsabilités.
Séparez les critères obligatoires des éléments utiles mais non décisifs. Si l’extraction ne trouve pas une information, traitez-la comme inconnue plutôt que comme absente. Si le sens d’un champ est incertain, revenez au CV et consignez la correction.
- Expériences : employeur, fonction, période et responsabilités décrites.
- Formation : intitulé et établissement tels qu’ils apparaissent dans le document.
- Compétences et langues : éléments explicitement mentionnés, avec le contexte utile.
- Points à vérifier : dates manquantes, chevauchements ou termes difficiles à interpréter.
Construire un test de contrôle utile
Préparez un petit échantillon de CV représentatif de vos documents : formats classiques, colonnes, fichiers multilingues et documents dont les dates ou le texte sont moins faciles à lire. Utilisez uniquement des documents que votre équipe est autorisée à traiter. Pour chaque cas, comparez le résultat au fichier source et notez le champ, l’erreur, la correction et la personne qui a vérifié.
Concentrez-vous sur les erreurs qui changeraient la compréhension du parcours : employeur attribué à la mauvaise expérience, dates inversées, compétence déplacée d’une rubrique à une autre ou langue omise. Une démonstration réussie sur un seul CV ne suffit pas; ce contrôle décrit seulement les cas observés dans votre échantillon, sans garantir le comportement sur les documents futurs.
Exemple fictif : vérifier une extraction avant de l’utiliser
Une équipe qui recrute une technicienne de maintenance teste trois CV. Sur le premier, le parser place une compétence de la colonne latérale sous le mauvais employeur. La recruteuse corrige l’association à partir du document. Sur le deuxième, l’expérience est décrite en anglais; l’équipe conserve l’intitulé original et ajoute une question sur les interventions chez des clients. Sur le troisième, une date de fin est illisible. Elle reste marquée comme incertaine au lieu d’être déduite.
La fiche de contrôle garde le type de mise en page, le champ extrait, la différence constatée, la correction et le nom du réviseur. Si un champ détermine l’adéquation à un critère, il est vérifié avant d’orienter la recherche ou une prise de contact.
Relier extraction et import de données
Le parsing et l’import ne sont pas la même étape. La documentation Yena décrit un parcours de migration où l’équipe mappe les colonnes d’un CSV, vérifie les données, puis lance l’import. Elle indique aussi que l’extraction de CV peut porter sur les expériences, la formation, les compétences et les langues. L’équipe doit contrôler la source et les champs avant de s’appuyer sur ces informations. Consultez le guide de migration en anglais pour les étapes disponibles; il ne promet ni extraction parfaite ni historique complet.
Lors d’un essai de workflow, définissez qui vérifie les champs, comment signaler une correction et quelle action suit une donnée incertaine. Testez avec un poste réel et un petit échantillon approprié, puis demandez si les résultats facilitent le travail de l’équipe sans effacer les incertitudes.
Tester un parser de CV sur des cas réels avant de l’adopter
Un parser de CV n’est utile que si les informations extraites restent vérifiables. Évaluez-le sur des documents variés, consignez les erreurs qui changeraient la lecture d’un profil et gardez une validation humaine pour les champs importants.
Sur petit écran, faites défiler le tableau horizontalement.
| Cas de test | Champs à comparer à la source | Action si le résultat est incertain |
|---|---|---|
| CV en deux colonnes | Ordre des expériences, employeurs, dates et compétences | Ouvrir le document source et corriger les champs mal associés |
| CV multilingue | Langue, intitulés, formation et périodes d’emploi | Conserver le terme d’origine si la traduction introduit une ambiguïté |
| Document avec dates ou contenu peu lisible | Début et fin des postes, noms d’employeurs, texte extrait | Marquer l’information comme à vérifier; ne pas déduire une date absente |
Comparez les champs qui influencent réellement votre recherche, corrigez-les à partir du CV et notez les types d’erreurs observés. Un test éditorial ne prouve pas qu’un outil conviendra à toutes les candidatures; il montre où l’équipe doit relire et quel workflow mérite un essai plus large.
Questions fréquentes
Quelles informations un parser de CV peut-il extraire ?
Selon le processus décrit dans la documentation Yena, l’extraction peut porter sur les expériences professionnelles, la formation, les compétences et les langues. Vérifiez chaque champ utile par rapport au CV source, car le résultat peut être incomplet ou ambigu.
Comment tester un parser de CV ?
Comparez les champs extraits au document d’origine sur des CV variés, notamment des mises en page à colonnes et des documents multilingues. Consignez les erreurs, les corrections et le réviseur pour les champs qui influencent la suite du recrutement.
Le parsing peut-il décider automatiquement qui recruter ?
L’extraction organise des informations du CV; elle ne remplace pas l’évaluation humaine des critères du poste. Vérifiez la source, traitez les champs incertains comme des questions et gardez un responsable pour les décisions de sélection.
Quelques-uns de nos clients
Essayez en équipe
Relier les critères du poste à une recherche vérifiable
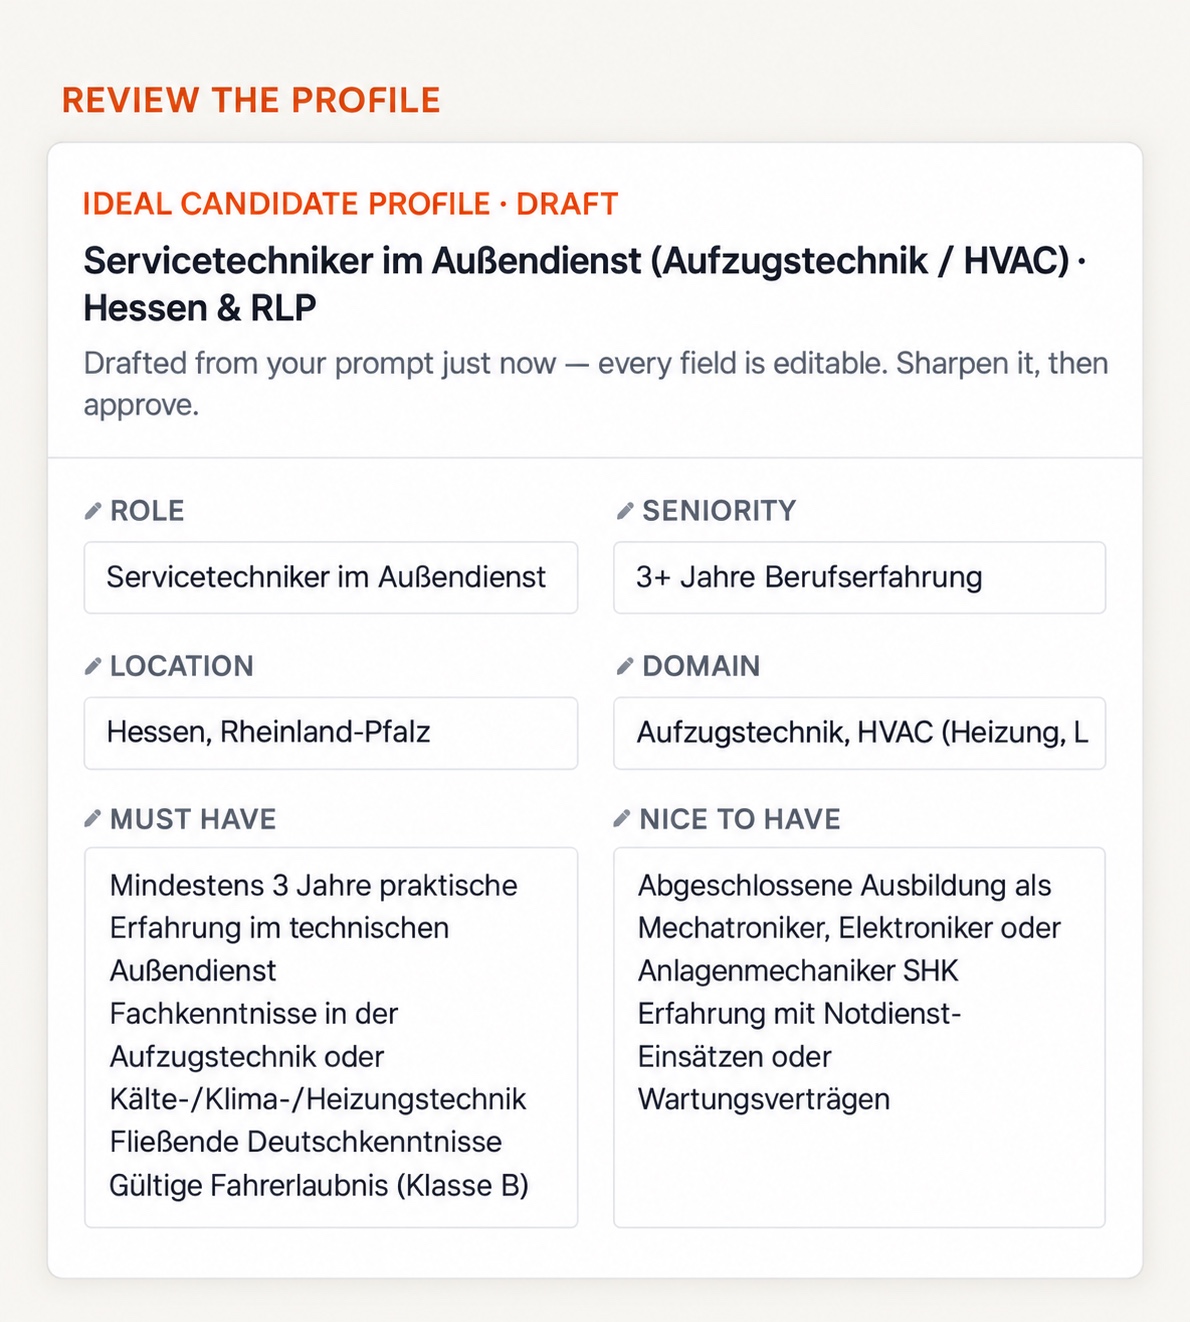
Le profil de recherche Yena permet de revoir le rôle, la région et les critères avant de lancer une recherche. Dans un essai Yena Team, validez un brief réel, puis examinez la pertinence des profils retournés avec votre équipe.
- Valider le rôle et les critères avant la recherche
- Distinguer un élément confirmé d’une information à vérifier
- Revoir la shortlist avec un recruteur responsable